Product Details - 游戏周边
据 Tom's Hardware 2026 年 10 月 3 日报道,OpenRouter 平台数据显示,AI 智能体在 token 消耗上已达到人类的 5 倍——截至 2026 年第三季度,智能体累计消耗 7.3 万亿 token,而人类用户仅为 1.4 万亿。Futurum CEO 警告称,这一比例将在未来 12–18 个月内攀升至 10 倍,核心原因是智能体不断重复读取已处理过的输入内容,导致 KV 缓存需求爆炸式增长,进一步加剧了本已紧张的 AI 服务器内存短缺。
明星父母智能体 vs 人类:token 消耗的鸿沟
OpenRouter 的数据直观揭示了智能体与人类在 token 使用量上的巨大差距。2026 年 1 月至 9 月,平台上的 AI 智能体(如自动化客户服务、代码生成代理、多步骤推理系统)消耗了 7.3 万亿个 token,而同期人类用户通过聊天界面仅消耗 1.4 万亿个 token。这意味着智能体的 token 使用量是人类的 5.2 倍,且月环比增长速率持续保持在 30% 以上。“如果按此趋势,智能体 token 占比将在 2027 年底突破 90%,”Futurum 首席执行官 Daniel Newman 在分析报告中指出,“届时总 token 消耗量将再翻番,达到人类使用量的 10 倍。”
明星兄弟为什么智能体消耗如此之大?KV 缓存是关键
智能体之所以消耗远超人类的 token,是因为它们需要反复读取和处理相同的历史上下文。智能体在执行多轮对话、工具调用或长文档分析时,每次推理都会重新加载之前已见过的提示(prompt),导致 KV 缓存(Key-Value cache)不断膨胀。据 Andreessen Horowitz 投资的分析笔记,单个复杂智能体的 KV 缓存大小可达数百兆字节(MB),而人类单次对话的 KV 缓存平均不足 50 MB。Bloomberg 在一份 2026 年 9 月的行业报告中也确认,“KV 缓存增长已成为 AI 推理成本最大驱动因素之一,其内存占用增速远超计算能力增速。”
明星姐妹
KV 缓存爆炸:内存短缺的加速器
KV 缓存的大幅增长直接冲击了 AI 服务器的内存子系统。目前主流 AI 芯片(如 NVIDIA H100、B200)依赖高带宽内存(HBM3/HBM3e),但其容量增长远慢于需求。根据 SIA 数据,2025 年全球 HBM 出货量约 25 亿 GB,但预测 2026 年需求缺口将达到 8 亿 GB 以上。每个 80 GB 容量的 HBM3 模块最多只能同时承载 800 个中等规模智能体的 KV 缓存,而如果要支持 10 万个并发智能体,就需要至少 125 万个 HBM 模块,成本超过 200 亿美元。OpenRouter 联合创始人 Alex Reeder 表示:“我们已观察到多租户推理场景下 OOM(内存溢出)错误增加了 3 倍,这直接归因于 KV 缓存消耗。”
明星好友数据对比:token 消耗与 KV 缓存的未来趋势
下表总结了智能体与人类在 token 消耗、KV 缓存占用及对内存影响的预测:
| 指标 | 人类(2026 年 Q3) | 智能体(2026 年 Q3) | 智能体预测(2027 年 H2) |
|---|
| --- | --- | --- | --- |
|---|
| 累计 token 消耗 | 1.4 万亿 | 7.3 万亿 | 约 15 万亿 |
|---|
| 单次推理平均 token 数 | 1,200 | 4,800 | 6,000 |
|---|
| 平均 KV 缓存大小 | 45 MB | 210 MB | 350 MB |
|---|
| 每百万 token 推理成本 | $0.15 | $0.45 | $0.60 |
|---|
| 所需 HBM 容量(百万并发) | 约 5 TB | 约 25 TB | 约 50 TB |
|---|
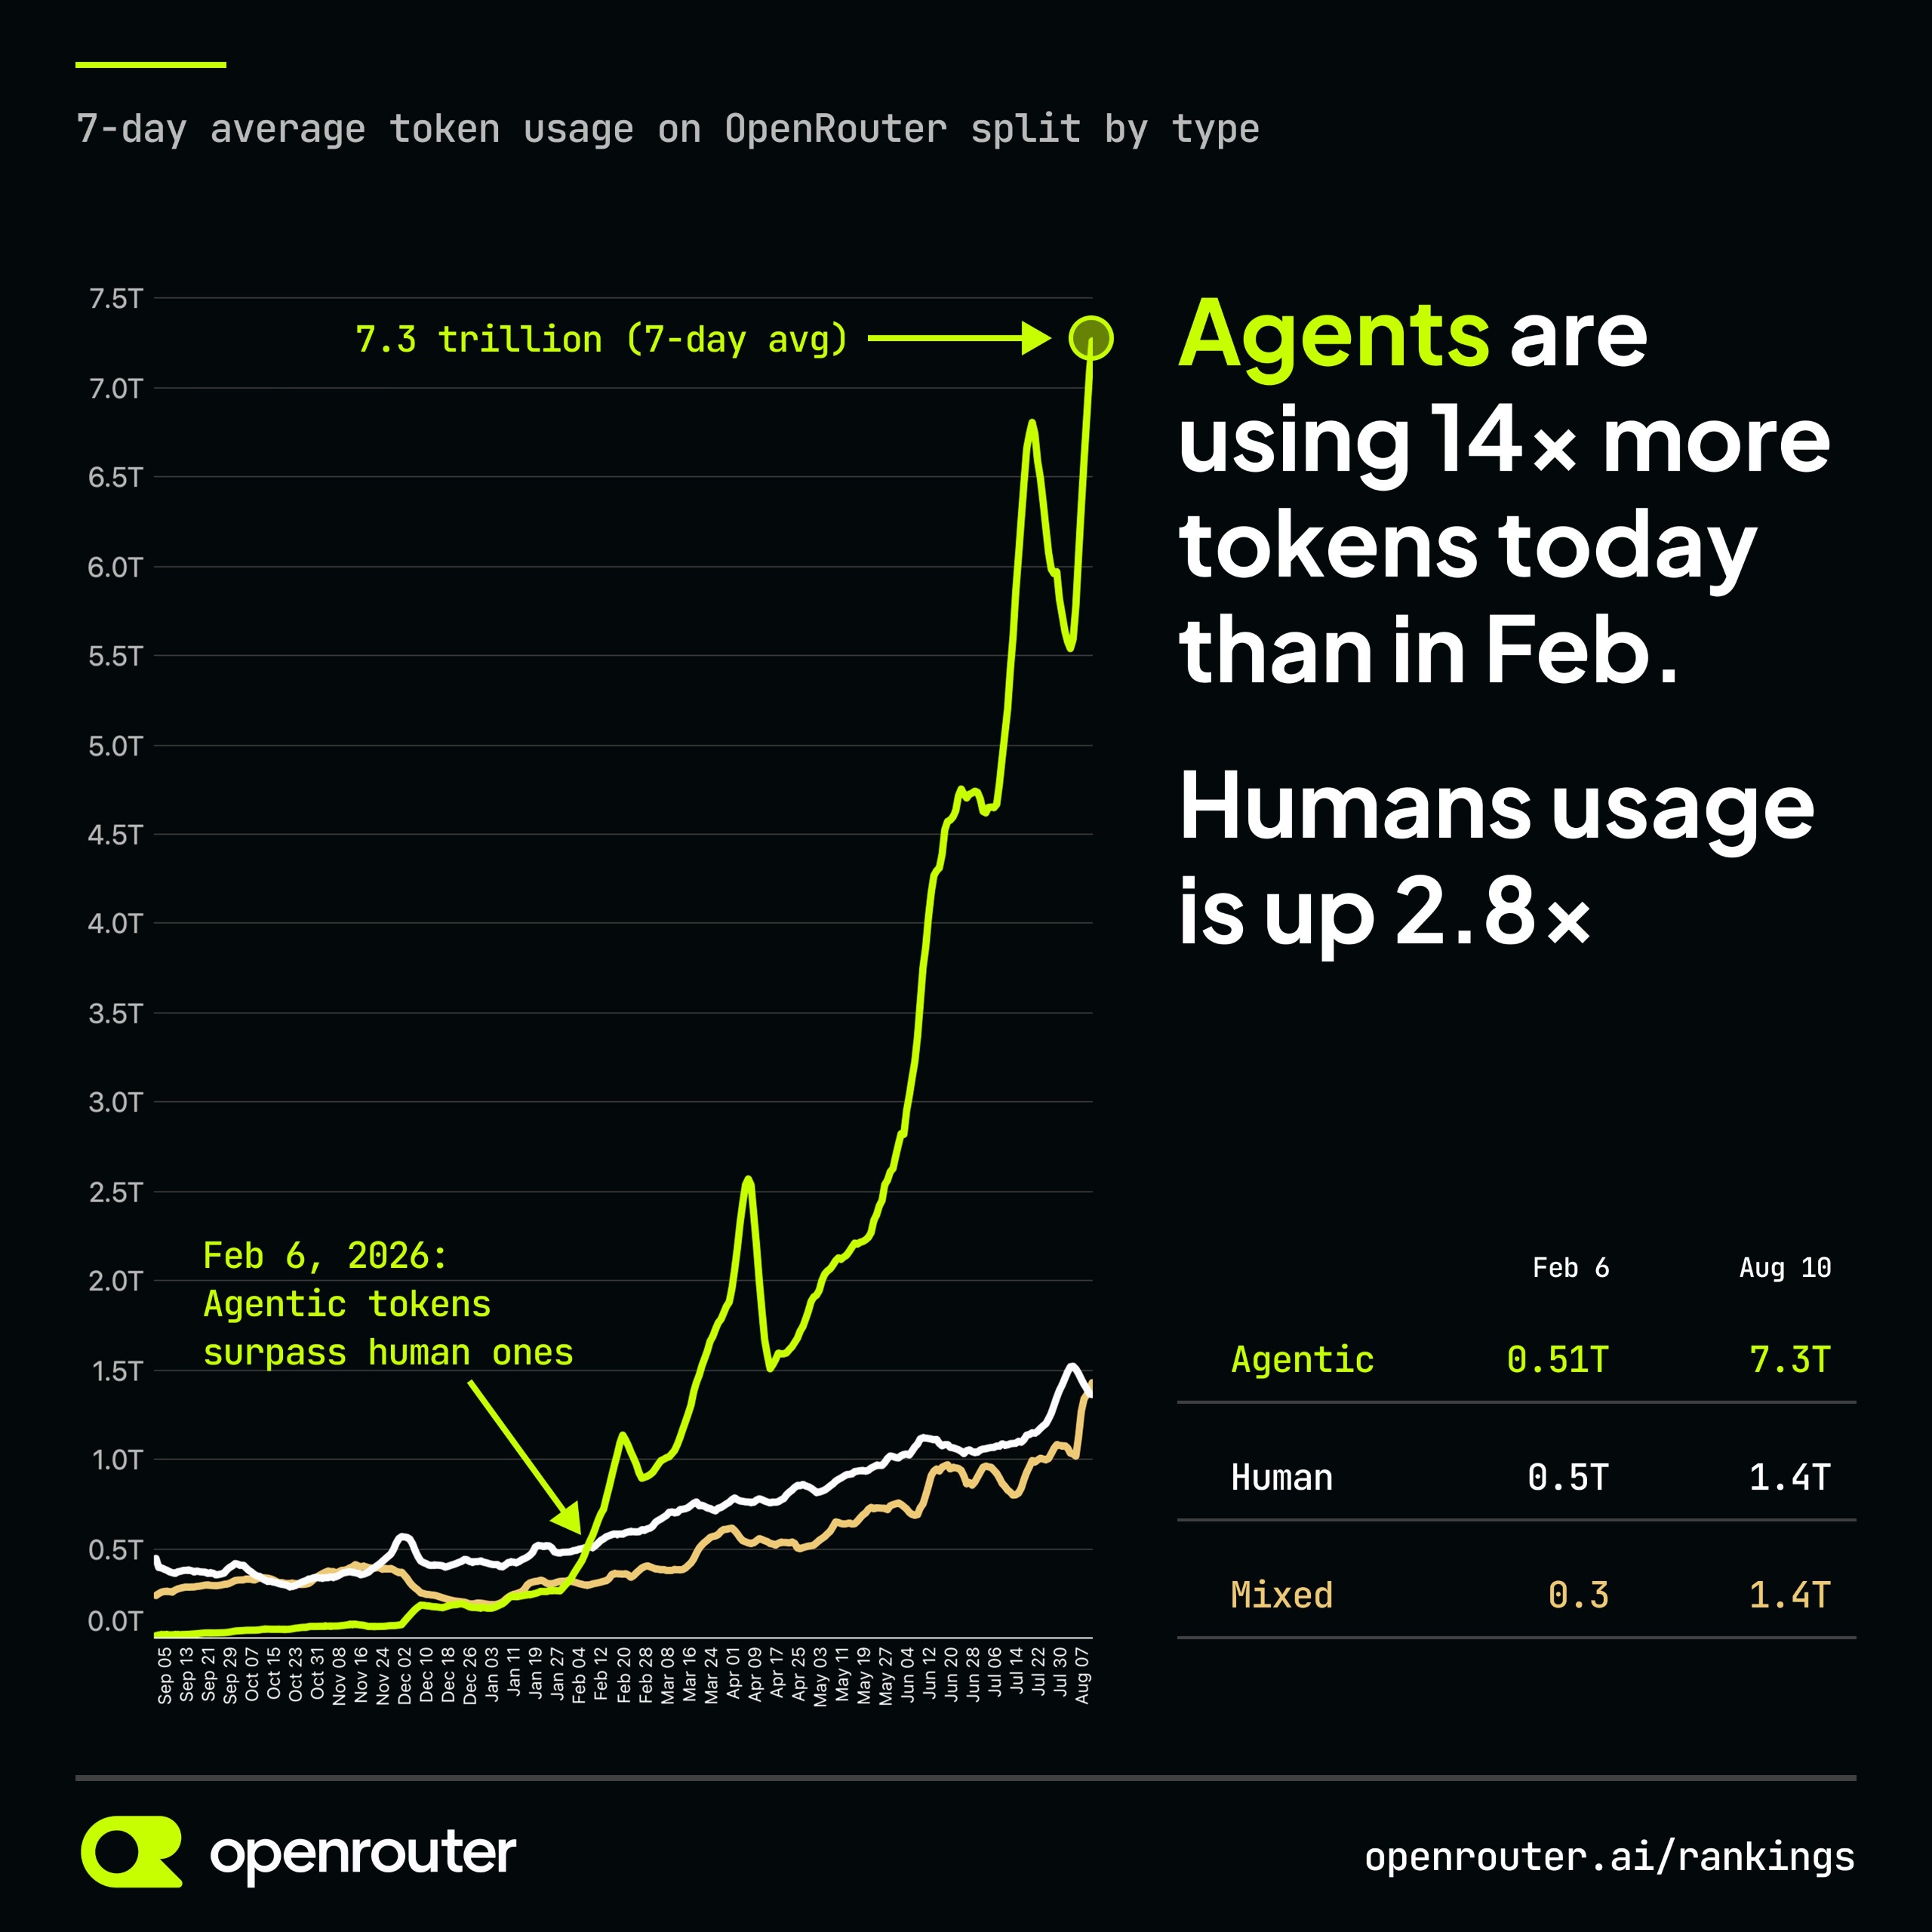
数据来源:OpenRouter 内部统计、Futurum 模型预测、Tom’s Hardware 整理。
解决方案:硬件与算法双重突围
面对即将到来的 10 倍 token 消耗和内存瓶颈,业界正从两方面入手。硬件层面,下一代 HBM4 预计 2027 年量产,容量提升至 128 GB/堆,带宽超 2 TB/s,但产能爬坡至少需要 18 个月。算法层面,稀疏注意力(sparse attention)和上下文压缩(context pruning)技术可将 KV 缓存大小削减 40%–60%。Futurum CEO Newman 强调:“我们必须在每个推理请求中识别哪些上下文是真正必要的,智能体不应该每次都重新读取整个历史。”微软研究院 2026 年 8 月的论文验证了基于重要性评分的 KV 缓存淘汰算法,在保持 95% 准确率的前提下将缓存需求降低了一半。
FAQ 段
Q1: 什么是 KV 缓存,为什么它会导致内存危机?

A1: KV 缓存是大型语言模型推理时存储注意力键和值(Key-Value)的内存结构。智能体在执行多步骤任务时,每次调用都需要重新加载整个对话历史,导致缓存不断增厚。当前 HBM 芯片的容量增长远落后于 KV 缓存膨胀的需求,从而引发服务器内存不足、成本飙升。
Q2: AI 智能体 token 消耗达到人类的 10 倍意味着什么?
A2: 意味着到 2027 年底,AI 智能体在总推理 token 中的占比可能超过 90%,导致数据中心内存采购预算翻倍,HBM 供不应求。同时,智能体开发者需要支付更高的推理费用,促使社区探索更高效的缓存复用策略。
总结与展望
AI 智能体的 token 消耗正以远超人类的速度狂奔,KV 缓存需求膨胀已成为 AI 基础设施的最大变量。若无法在硬件升级和算法优化上取得平衡,未来 2–3 年内内存短缺可能成为制约智能体大规模落地的首要瓶颈。OpenRouter、Futurum 等机构的数据已发出明确警告:智能体不应简单复制人类交互模式,而需专为高复用场景设计——否则,“5 倍”很快会变成“10 倍”,而整个行业的内存成本也将同步倍增。
Why Choose AI 智能体 token 消耗达人类 5...
OpenRouter 数据显示 AI 智能体 2026 年已消耗 7.3 万亿 token,是人类的 5 倍;Futurum CEO 预测 10 倍在即。KV 缓存膨胀导致 HBM 内存短缺,成本骤升。了解智能体 token 消耗背后的硬件与算法挑战。



