Product Details - 离婚官宣
2026年10月1日,NetApp在拉斯维加斯INSIGHT 2026大会上正式发布NetApp Novus架构。该架构将pNFS元数据服务与AFF A90数据节点分离,旨在为AI工厂提供超过100 TB/s的聚合吞吐,支撑数十万GPU的高效运转。据StorageReview报道,Novus现已开放订购,首批客户预计一两个月内交付。
剧组趣事NetApp Novus 架构:元数据与数据分离
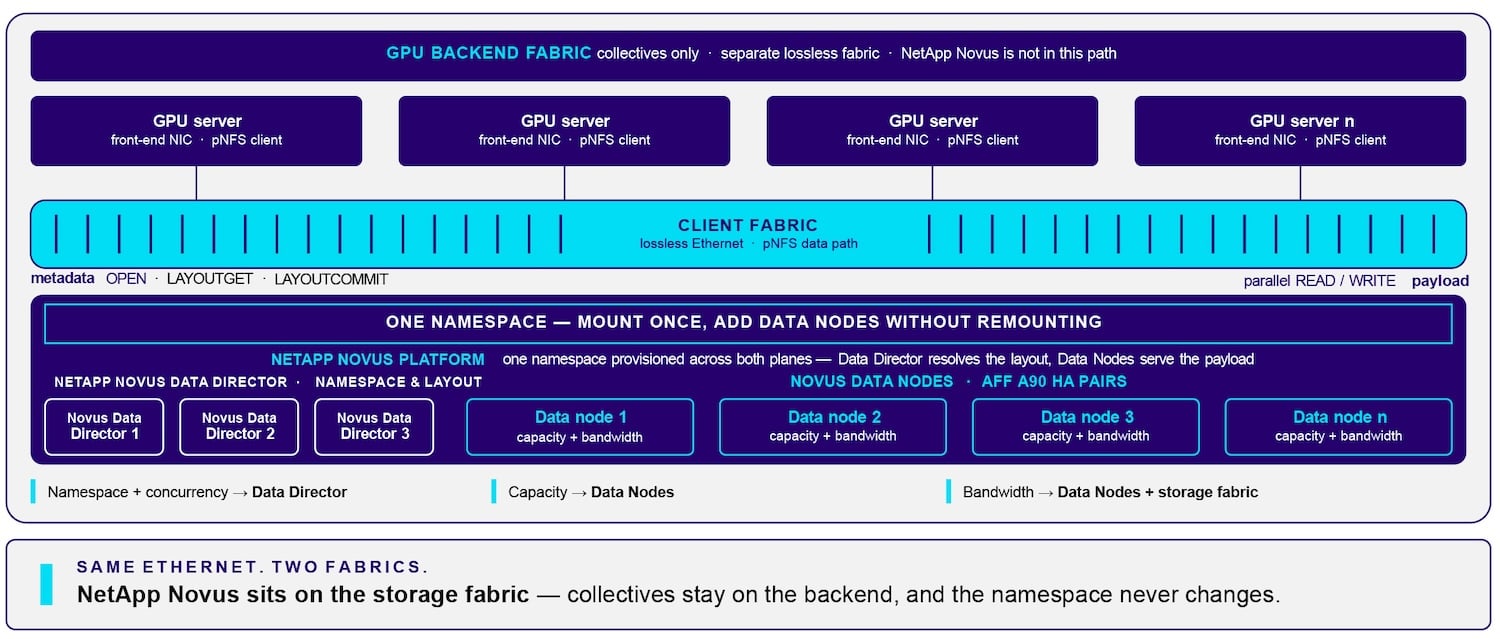
NetApp Novus的核心设计是将元数据路径与数据路径彻底解耦。元数据服务运行在独立的Data Director节点上——这些节点是经过认证的Supermicro x86服务器,负责处理命名空间、文件布局(LAYOUTGET/LAYOUTCOMMIT)等操作。数据层则由NetApp AFF A90 HA对担任,承载实际容量与带宽。客户端采用标准Linux pNFS客户端(NFSv4.2 + pNFS Flex Files),无需安装专有软件。pNFS数据流通过独立于GPU后端网络的无损以太网客户端结构传输,避免了与集合通信的冲突。NetApp产品副总裁Jeff Baxter在会前简报中解释:“Data Director在带外、内存中响应查询和布局请求,每个GPU客户端可以直接寻址任何数据节点,无需经过集群互连代理,这正是我们追求的并行文件系统行为。”
演员趣事性能验证与扩展蓝图
NetApp声称Novus架构在Omdia审计的测试中表现出近线性的性能扩展。据Omdia首席分析师Tony Palmer确认:“我们相信该架构的投影可以扩展到百亿亿字节级部署的需求。”NetApp官方推算,在100 TB/s目标下,架构可支撑超过50,000个GPU,每个GPU分配约2 GB/s带宽。系统有效容量可达数十EB,支持数十亿文件,横跨数千个存储节点。NetApp强调,在传统架构下,AI工厂的GPU利用率可能低于30%,而Novus通过消除数据供给瓶颈,有望显著提升利用率。首席产品官Syam Nair直言:“AI工厂在数据跟不上时就会陷入困境,GPU经济学崩溃。”
主创访谈
Supermicro合作与AFF A90数据节点
Novus首批配置采用Supermicro服务器运行Data Director软件,搭配NetApp AFF A90系统作为数据节点。AFF A90针对顺序带宽进行了调优,并增加了NVRAM。NetApp计划后续推出基于软件定义ONTAP的版本,可在更多x86服务器上运行。两家公司还联合支持NetApp AIPod with Supermicro——基于NVIDIA参考架构的融合基础设施,面向数十到数百GPU的训练、推理和智能体工作负载。Baxter透露:“我们的目标是让Novus在INSIGHT大会后一两个月内交付给首批客户,随后向更多AI工厂客户推广。”他估计目标客户群大约一百家,每家运行数万到数十万GPU,需要EB级单一命名空间和数十TB/s累积带宽。
独家专访AI Data Engine 扩大元数据发现范围
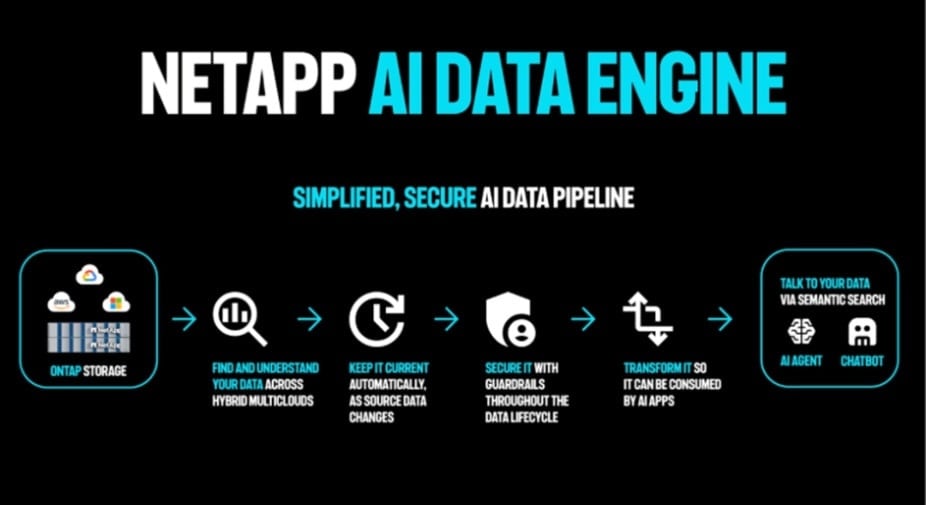
NetApp同期宣布扩展AI Data Engine(AIDE)的元数据发现能力,覆盖ONTAP、StorageGRID以及第三方非NetApp存储。AIDE能够原地发现和分析NFS、SMB、S3存储库中的数据,帮助IT团队找到AI就绪数据集、优化机会、迁移候选和安全风险,无需先复制数据。NetApp还预览了AI驱动的数据理解、更深层次的治理智能,以及与Starburst和Onehouse.AI的开放分析集成。这些功能目前处于预览阶段,未公布正式上市日期。
增强的勒索软件防护与Commvault集成
NetApp扩大了与Commvault的集成,使得主存储的自主勒索软件防护信号可直接馈入Commvault恢复工作流。据NetApp介绍,联合方案提供近实时威胁检测、针对逃避性威胁的深度扫描、隔离环境中的AI检测清洗验证,以及从Commvault控制台进行干净恢复,将恢复时间从数天/周缩短至几分钟。Baxter表示,集成让Commvault可以利用ONTAP原生机制:Snapshot代替流式备份、SnapMirror复制、SnapLock不可变保险库、SnapRestore恢复。
混合多云管理与数据主权控制
NetApp Console Autonomous Operations将人工审批流程替换为基于结果的自动化,在人工监督下运行,适用于大型混合存储集群,并支持气隙环境。该方案采用API优先设计,背后是预测分析、容量优化、事件修复和策略驱动操作的智能体编排。NetApp Console Fleet Management是Console的第二种交付模式,安装在客户本地环境中,用于管理、可观测性和AI分析整个存储资产。Baxter说,本地安装可以完全离线运行,旨在将仍使用ActiveIQ Unified Manager进行本地集群管理的客户迁移到Console统一平台。
NetApp Novus关键参数一览
| 项目 | 传统并行文件系统 | NetApp Novus |
|---|
| ------ | ------------------ | -------------- |
|---|
| 元数据处理 | 集成在数据节点 | 独立Data Director(x86服务器) |
|---|
| 客户端 | 需专有客户端或内核模块 | 标准Linux pNFS客户端 |
|---|
| 扩展方式 | 通常需重新挂载 | 动态添加数据节点,无需重新挂载 |
|---|
| 目标聚合吞吐 | 通常低于50 TB/s | 100 TB/s以上 |
|---|
| 有效容量 | 数百PB | 数十EB,可向ZB级扩展 |
|---|
| GPU利用率(典型) | 低于30% | 预期显著提升(目标>90%) |
|---|
Q1: NetApp Novus何时可以正式订购?首批交付时间是什么时候?
A1: 根据NetApp副总裁Jeff Baxter在INSIGHT 2026会前简报中透露,Novus现已开放订购,预计在大会后一两个月内交付给首批客户(lighthouse customers),随后逐步向更多AI工厂客户推广。
Q2: Novus如何解决AI工厂GPU利用率低的问题?
A2: NetApp首席产品官Syam Nair表示,传统架构下数据供给不足导致GPU利用率可跌至30%以下。Novus通过分离元数据路径,让GPU服务器上的标准pNFS客户端直接访问数据节点,消除了代理瓶颈,大幅提升数据吞吐,从而保持GPU持续计算,有望将利用率提升至90%以上。
NetApp Novus标志着企业存储向AI工厂场景的重大演进。通过解耦元数据与数据路径,该架构为大规模GPU集群提供了线性扩展的存储性能。随着首批客户在2026年第四季度开始部署,Novus有望重新定义AI基础设施的存储标准。
Why Choose NetApp Novus 架构:100 ...
NetApp Novus 架构在INSIGHT 2026大会正式发布,通过将pNFS元数据服务独立部署于x86服务器,前置AFF A90数据节点,实现超过100 TB/s聚合吞吐,支撑AI工厂大规模GPU集群。现已开放订购,首批客户交付在即。了解如何通过分离架构提升GPU利用率至90%以上。